Como este será el primer blog que haré sobre esta aventura en el machine learning, y en el que detallo un poco de lo que aprendí en el máster con este Kaggle, verán cosas interactivas para sumergirnos en cada fase y que el proceso sea divertido: tanto la inicial, que es la recolección de datos, como la exploratoria o EDA (Exploratory Data Analysis).
Recuerda que, por ahora, no estás intentando predecir nada todavía. Estás descubriendo cómo se comportan los datos. Antes de seguir con este problema de regresión, empecemos por lo más básico: ¿qué es una función lineal?
¿Qué es una función lineal?
De forma sencilla, una función lineal se expresa así:
Lo que estimamos. es el resultado: en nuestro ejemplo, la nota estimada del examen. Es una estimación, no la nota real.
Si queremos estimar cuánto podríamos sacarnos en un examen de la universidad estudiando horas, la nota que calculamos como estimación (no la real) será , según las horas de estudio que hagamos.
Entonces, si, por ejemplo, no estudio, la nota estimada será de 3 puntos, siendo la variable de intercepto. Es decir, es el valor de cuando .
Ahora imagina que estudié 2 horas en la tarde, pero hice horas extras en la noche. Esas horas extras también cuentan como horas de estudio, así que aumentan . Digamos que por cada hora extra la nota estimada sube 1 punto. Esto nos ayuda a entender el parámetro , al que llamamos pendiente: nos dice cuánto cambia cada vez que cambia.
Entonces, si estudiamos 4 horas, nuestra ecuación quedaría así:
Nota estimada: 7.
y = 1(4) + 3 = 7
¿Qué es una regresión lineal?
Una regresión es una forma de predecir una variable, la Dependiente e independiente solo dicen qué papel juega cada variable en el modelo: es lo que queremos predecir y lo que usamos para predecirla. No significa que una cause a la otra. (, la nota), a partir de otra, la independiente (, las horas de estudio). En la vida real, dos personas que estudian las mismas horas no sacan la misma nota, así que la regresión no intenta adivinar la nota exacta de cada una, sino el promedio de las notas de quienes estudian esas horas. En estadística, ese promedio se llama En rigor, la esperanza es el promedio de toda la población, de todas las personas que podrían estudiar esas horas. El promedio que calculamos con nuestros datos es una estimación de ella. y se escribe así:
La esperanza. La viene de esperanza (en inglés, expectation): el valor que esperas obtener en promedio.
Se lee "el valor esperado de cuando conocemos ". Una regresión lineal supone además que ese promedio cambia en línea recta con :
Es decir, la regresión lineal usa una función lineal para describir cómo cambia el promedio de , y calcula esa recta a partir de datos reales.
Ahora, teniendo esto en cuenta, ¿cuándo una función lineal se vuelve una regresión lineal?
La función lineal es la forma del modelo. Es la regla que relaciona con . En una regresión lineal no conocemos ni , ya que los calculamos con datos reales.
Agregamos también un término de error , porque los datos reales no caen perfectos sobre la recta:
El valor real. es lo que de verdad pasó: la nota que de verdad sacó una persona. Aquí ya no es el promedio.
Para entenderlo mejor: estudiamos 4 horas y sacamos 7, pero un compañero estudió 4 horas y sacó 6, mientras que otro estudió las mismas horas y sacó 8.
La diferencia entre la nota que saca cada compañero y lo que nos dice la recta () es lo que llamamos el En rigor, es el error respecto de la recta verdadera, que nunca conocemos. Cuando estimamos y con los datos, las diferencias que sí podemos calcular se llaman residuos y se escriben o . Por eso, más adelante, la gráfica se llama "de residuos". :
Entonces:
- Si la nota real es 7 y la recta dice 7, el error es 0.
- Si la nota real es 6 y la recta dice 7, el error es .
- Si la nota real es 8 y la recta dice 7, el error es .
Valeria, Mateo y Sofía estudiaron 4 horas, así que la recta les da la misma nota a los tres.
recta = 1(4) + 3 = 7
nota real = recta + ε
8 = 7 + (+1)
sacó más de lo que dice la recta
7 = 7 + (0)
cae justo sobre la recta
6 = 7 + (−1)
sacó menos de lo que dice la recta
Por eso se agrega : porque la realidad nunca es perfecta. La recta solo da el valor estimado, no el exacto.
Así se ve en el ejemplo: Valeria, Mateo y Sofía estudiaron 4 horas y sacaron 8, 7 y 6. La recta no puede acertarles a los tres; lo que predice es su promedio, 7, y cada uno se aleja de ella por su propio error . Que la relación sea una recta es un supuesto del modelo: si los datos no se comportan así, el modelo se equivoca de forma sistemática, y más adelante veremos justo eso con los fumadores.
¿Cómo se encuentran m y b?
En el ejemplo de las horas, nosotros elegimos y . Con datos reales no los conocemos: hay que estimarlos a partir de los datos. El método más usado es el de mínimos cuadrados ordinarios (OLS, por sus siglas en inglés). La idea es quedarse con la recta que deja más pequeña la suma de los errores al cuadrado (SSE, del inglés Sum of Squared Errors). La fórmula es larga, así que conviene leerla por piezas: sigue los pasos en orden, o pasa el puntero o toca cada pieza de la fórmula.
El error de cada persona. es el error de la persona : su valor real menos lo que dice la recta. Para Valeria, . La solo numera a las personas, de la a la .
Veámoslo con números. Volvamos a Valeria, Mateo y Sofía, que estudiaron 4 horas, y a la recta del ejemplo, . Para 4 horas, la recta dice , así que el error de cada uno es su nota real menos 7:
| Persona | Nota real | La recta dice | Error | Error al cuadrado |
|---|---|---|---|---|
| Valeria | 8 | 7 | +1 | 1 |
| Mateo | 7 | 7 | 0 | 0 |
| Sofía | 6 | 7 | −1 | 1 |
La suma de la última columna es la SSE de esta recta: . Si sumáramos los errores sin elevarlos al cuadrado, daría , como si la recta hubiera acertado con los tres, cuando en realidad falló con dos. Otra recta daría otra suma; mínimos cuadrados busca la recta con la suma más pequeña. Fíjate también en que el error se mide en vertical, entre el punto y la recta, no en perpendicular.
Ahora con nueve estudiantes. Cada punto es uno de ellos: su posición en el eje horizontal () son sus horas de estudio y en el vertical (), su nota. La línea punteada que baja (o sube) hasta la recta es su error, y la caja que la acompaña es un cuadrado cuyo lado mide exactamente ese error, así que su área es el error al cuadrado. La suma de todas las áreas es la SSE. Mueve la recta con y : la mejor es la que deja la menor área total, y al pasar el puntero (o tocar) por un estudiante verás su cuenta completa.
y = 0,35x + 5,20
Elige un estudiante en la gráfica (pasa el puntero, haz clic o tócalo) para ver cómo se calcula su error.
Suma de errores al cuadrado 13,50mínimo posible 2,96
No hace falta probar rectas una por una: esa suma tiene un mínimo que se puede calcular directamente,
Cómo se mueven juntas. y son el promedio de las horas y el de las notas. Para cada estudiante se mide cuánto se aleja de cada promedio y se multiplican: si quien estudia más de lo normal también saca más de lo normal, el producto es positivo. Con nuestros nueve estudiantes, la suma da .
Con estos nueve estudiantes da y , muy cerca de la recta que elegimos a mano. Esto es exactamente lo que hace LinearRegression de scikit-learn cuando más adelante llamamos a model.fit(): calcula estos números a partir de los datos. Si además suponemos que los errores siguen una distribución normal, el método de máxima verosimilitud llega a la misma recta.
Medical Cost Personal
Antes de entrenar cualquier modelo hay que tener los datos con los que vamos a estimar y . En esta etapa lo primero que harías es la recolección: reconocer en cada dato si es un dato de entrada (raw data) o la etiqueta que queremos predecir (labels).
En este caso usaremos el dataset Medical Cost Personal, que contiene información de personas como edad, sexo, IMC, si fuman, región y número de hijos. Esas son las variables de entrada (), o sea, los datos que el modelo usará para aprender.
La etiqueta () es el costo médico de cada persona, que es lo que queremos predecir.
Entonces:
- : edad, sexo, IMC, fumador, región, hijos.
- : costo médico.
Con esos datos, la regresión lineal buscará los valores de y que mejor relacionen las entradas con el costo médico.
Descargar el dataset desde Kaggle
Hay varias formas de importar los datos que queremos: desde Drive, desde nuestro equipo o, en nuestro caso, desde Kaggle. Importamos la librería de Google Colab para usar su clase files e instalamos la librería de Kaggle para descargar el dataset que está en la plataforma.
from google.colab import files
!pip install -q kaggle
Luego subimos nuestro archivo access_token para poder usar la librería de Kaggle (lo encuentran en https://www.kaggle.com/settings/api). Para esto usamos files y su función upload: al ejecutarla, nos pedirá que subamos un archivo.
uploaded = files.upload()access_token(n/a) - 38 bytes, last modified: 28/9/2026 - 100% done
Saving access_token to access_tokenMovemos el access token a la carpeta .kaggle de nuestro root.
!mkdir /root/.kaggle
!mv access_token /root/.kaggle/access_token
Y ahora, con el comando kaggle, descargamos nuestro dataset mirichoi0218/insurance.
!kaggle datasets download -d mirichoi0218/insuranceWarning: Looks like you're using an outdated `kaggle` version (installed: 2.0.2), please consider upgrading to the latest version (2.2.2)
Dataset URL: https://www.kaggle.com/datasets/mirichoi0218/insurance
License(s): DbCL-1.0
Downloading insurance.zip to /content
100% 16.0k/16.0k [00:00<00:00, 27.1MB/s]Cuando tengamos el zip, lo descomprimimos.
!unzip insurance.zipLeer el CSV
Ahora, entrando en la parte exploratoria, usaremos pandas: una biblioteca que convierte datos crudos en tablas manejables (los DataFrames, tablas bidimensionales parecidas a las de Excel, con filas y columnas) para limpiar, filtrar, agrupar, combinar y analizar información con pocas líneas de código.
import pandas as pdinsurance_data = pd.read_csv("./insurance.csv")insurance_data| age | sex | bmi | children | smoker | region | charges | |
|---|---|---|---|---|---|---|---|
| 0 | 19 | female | 27.900 | 0 | yes | southwest | 16884.92400 |
| 1 | 18 | male | 33.770 | 1 | no | southeast | 1725.55230 |
| 2 | 28 | male | 33.000 | 3 | no | southeast | 4449.46200 |
| 3 | 33 | male | 22.705 | 0 | no | northwest | 21984.47061 |
| 4 | 32 | male | 28.880 | 0 | no | northwest | 3866.85520 |
| ... | ... | ... | ... | ... | ... | ... | ... |
| 1333 | 50 | male | 30.970 | 3 | no | northwest | 10600.54830 |
| 1334 | 18 | female | 31.920 | 0 | no | northeast | 2205.98080 |
| 1335 | 18 | female | 36.850 | 0 | no | southeast | 1629.83350 |
| 1336 | 21 | female | 25.800 | 0 | no | southwest | 2007.94500 |
| 1337 | 61 | female | 29.070 | 0 | yes | northwest | 29141.36030 |
1338 rows × 7 columns
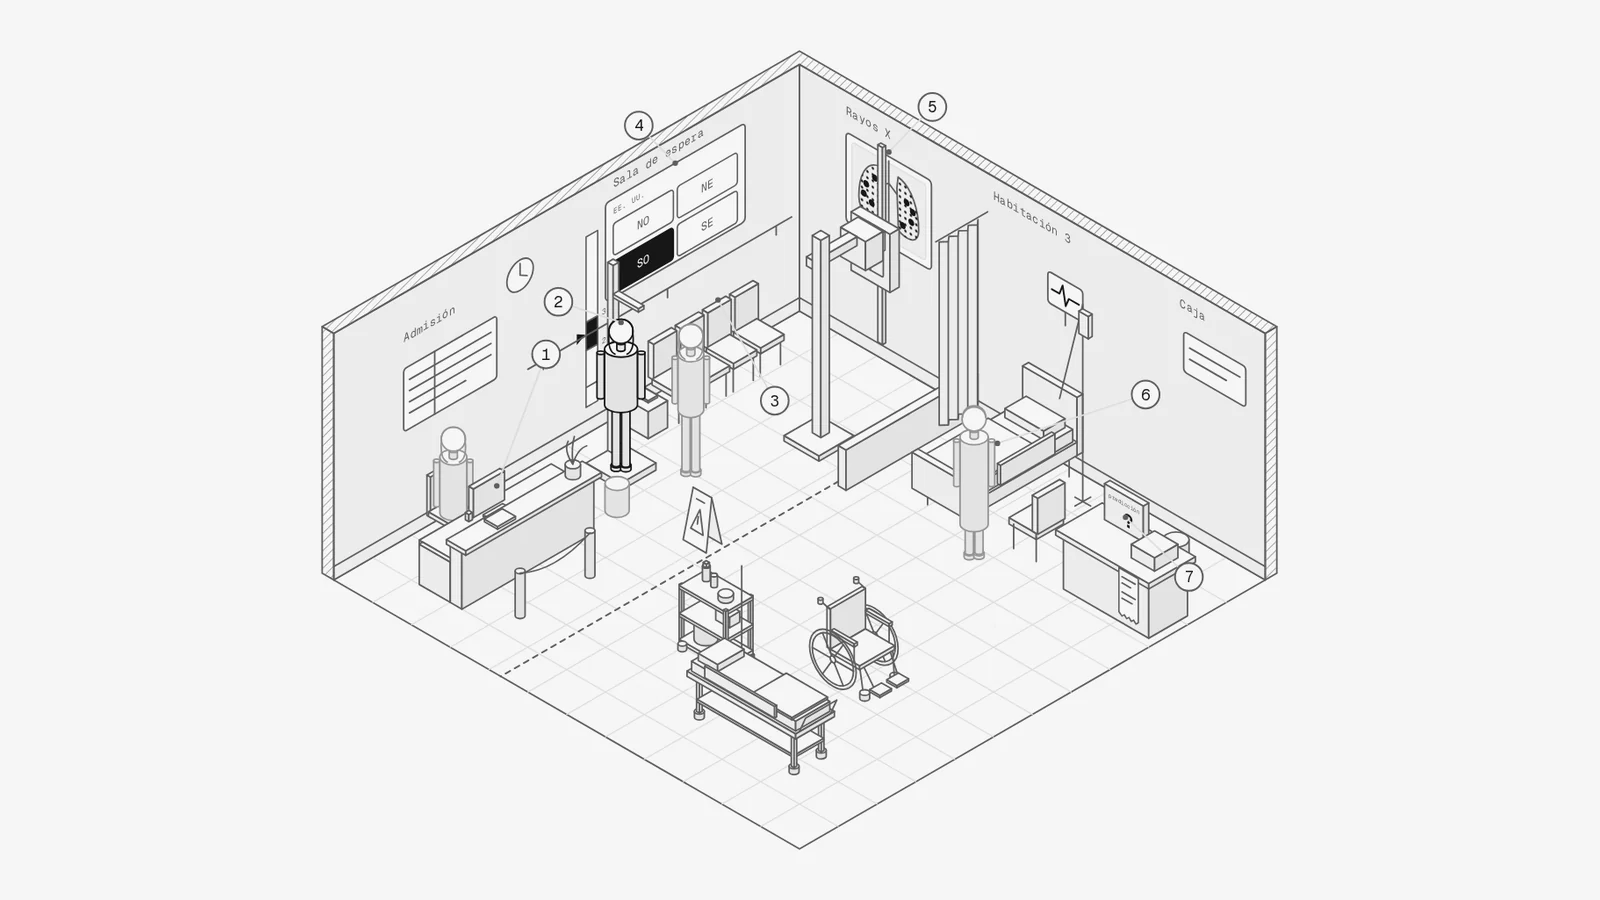
¿Se pueden predecir los costos del seguro? Las estaciones 1 a 5 son lo que el seguro sabe de alguien cuando lo afilia. La 7 es lo que termina pagando. Elige un paciente real y recorre el plano.
| # | age | sex | bmi | children | smoker | region | charges |
|---|---|---|---|---|---|---|---|
| 0 | 19 | female | 27.9 | 0 | yes | southwest | 16884.92 |
X raw datay label1 de 1.338 filas
Datos en el mundo real
Algo importante: en un caso real, la recolección de datos rara vez es tan sencilla. Puede que la empresa o la institución no tenga sus datos ordenados, o que ni siquiera tenga claro qué información tiene, y entonces te tocará buscarlos, organizarlos y sanear esos datos antes de poder hacer el EDA. Pueden venir en formatos distintos (CSV, Excel, SQL) y traer valores nulos, filas duplicadas, escalas diferentes o variables que repiten la misma información. Aquí trabajamos con un dataset de Kaggle que ya viene organizado y trae lo necesario, así que por ahora solo nos preocupa descargarlo; después entramos en la fase exploratoria y ahí analizamos los datos.
Con pandas conviertes esos datos crudos en un DataFrame (la tabla manejable). Lo usas para:
- Limpiar: quitar nulos y corregir tipos de datos.
- Filtrar y organizar: quedarte solo con las columnas útiles.
- Analizar: ver promedios, distribuciones y correlaciones.
- Normalizar o estandarizar: poner todas las variables en la misma escala.
Cuando hayamos hecho esto, podemos dividir los datos en dos partes. La primera es el conjunto de entrenamiento (training set): la porción más grande de tus datos (normalmente el 70 % u 80 %). Son los datos que el algoritmo "ve" y estudia para aprender los patrones, como cuando le das a un estudiante los libros y apuntes para que estudie. El modelo ajusta sus parámetros internos a partir de estos datos.
La segunda es el conjunto de prueba (test set): la porción restante (el 20 % o 30 %). Estos datos se guardan bajo llave y el modelo nunca los ve durante el entrenamiento. Se usan al final para evaluar qué tan bien aprendió, como un examen final con preguntas que no estaban en los apuntes, para ver si el estudiante de verdad entendió la materia o solo memorizó.
¿Por qué es tan importante hacer esta división?
Imagina que entrenas el modelo con todos tus datos y luego lo evalúas con esos mismos datos. El modelo va a acertar casi todo, pero no porque sea inteligente, sino porque ya vio las respuestas. Esto se llama sobreajuste (overfitting). Al separar un conjunto de prueba, te aseguras de que el modelo pueda generalizar y funcione bien con datos nuevos del mundo real.
- Train: estudiar (ver y aprender).
- Test: el examen final (evaluar con datos que nunca vio).
Análisis exploratorio
Entrando ahora en detalle, estos son nuestros datos:
insurance_data.describe().transpose()| count | mean | std | min | 25% | 50% | 75% | max | |
|---|---|---|---|---|---|---|---|---|
| age | 1338.0 | 39.207025 | 14.049960 | 18.0000 | 27.00000 | 39.000 | 51.000000 | 64.00000 |
| bmi | 1338.0 | 30.663397 | 6.098187 | 15.9600 | 26.29625 | 30.400 | 34.693750 | 53.13000 |
| children | 1338.0 | 1.094918 | 1.205493 | 0.0000 | 0.00000 | 1.000 | 2.000000 | 5.00000 |
| charges | 1338.0 | 13270.422265 | 12110.011237 | 1121.8739 | 4740.28715 | 9382.033 | 16639.912515 | 63770.42801 |
Análisis descriptivo del conjunto de datos de seguros
describe() resume cada columna numérica en ocho números. Leídos con nuestros datos:
- Cuántos datos hay (
count). Hay 1338 registros en cada una de las columnas numéricas (age,bmi,children,charges), así que no falta ningún valor en ellas. - El promedio (
mean).- La edad promedio es de unos 39 años.
- El índice de masa corporal (IMC,
bmi) promedio es de 30.66, que técnicamente ya cae en el rango de obesidad (30 o más). - En promedio, cada asegurado tiene 1 hijo.
- El costo médico promedio es de $13,270.42.
- La dispersión (
std). Mide cuánto se alejan los datos del promedio. En la edad es de 14.05 años: la mayoría de las personas tiene entre 25 y 53 años, es decir, el promedio ± la desviación estándar. - Los mínimos (
min). La persona más joven tiene 18 años y el costo más bajo es de $1,121.87. - La mediana (
50%). Es el valor justo en medio de los datos ordenados: la mitad de las personas tiene 39 años o menos y la otra mitad, 39 o más. Como es casi igual a la media (39.2), la edad se reparte de forma bastante simétrica. - Los cuartiles (
25%y75%). El 25 % más joven tiene 27 años o menos, y el 75 % tiene 51 años o menos, así que solo una cuarta parte supera los 51.
El costo no se comporta igual: su mediana ($9,382.03) queda muy por debajo de su media ($13,270.42). Eso pasa cuando unos pocos costos muy altos arrastran el promedio hacia arriba, y es la primera pista de algo que veremos más adelante en el histograma.
Para saber, como mencionamos antes, si tenemos valores nulos o vacíos, con pandas también podemos revisarlos y tratarlos.
insurance_data.isnull().sum()age 0
sex 0
bmi 0
children 0
smoker 0
region 0
charges 0
dtype: int64Edad contra costo
En la fase exploratoria, mientras analizamos los datos, también conviene tener una idea más visual de lo que está pasando. Para esto tenemos Matplotlib (una librería para crear gráficas a bajo nivel, poniendo títulos, barras, líneas, etc.) y Seaborn, una capa de alto nivel sobre Matplotlib en la que las gráficas complejas ya vienen preparadas para usarse en pocas líneas de código.
import matplotlib.pyplot as plt
import seaborn as snssns.set(style="darkgrid")
sns.regplot(x="age", y="charges", data=insurance_data)<Axes: xlabel='age', ylabel='charges'>fumano fuma
1338 personas del dataset · R² = 0,09
Pasa el puntero por un punto para ver quién es y qué tan lejos quedó su costo real de la predicción.
Entonces sns.regplot(x="age", y="charges", data=insurance_data) hace dos cosas:
- Dibuja cada persona como un punto: la edad en el eje horizontal y el costo médico en el vertical.
- Ajusta la recta que mejor se pega a esos puntos, mostrando la tendencia entre edad y costo.
Y esa recta es justamente la forma que veníamos viendo:
- (edad): es la variable de entrada, la que ya conoces y usas para predecir.
- (charges): es la etiqueta, lo que quieres predecir.
Preguntas
¿A mayor edad, mayores son los costos médicos? Si la recta va hacia arriba (pendiente positiva), la respuesta es sí: a mayor edad, mayor costo médico estimado. Si fuera plana, no habría relación.
¿Qué tan fuerte es esa relación? Si los puntos están muy pegados a la recta, la relación es fuerte; si están muy dispersos, es débil. Por ejemplo, para una persona de 20 años la recta estima unos 8 mil, pero entre los 18 y los 22 años hay quien paga casi 45 mil. Pasa el puntero por los puntos de la gráfica para ver cuánto se aleja cada persona de la recta.
¿Hay valores atípicos? Los puntos que se alejan mucho de la recta avisan de posibles errores o de casos especiales. Y sí los hay: personas jóvenes con costos altísimos (quizás fuman o tienen alguna enfermedad) y personas mayores con costos bajos. Con esto vemos que la edad por sí sola no basta para predecir el costo médico.
Tipos de variables
insurance_data.dtypesage int64
sex object
bmi float64
children int64
smoker object
region object
charges float64
dtype: objectPara poder hacernos más preguntas como estas, primero identificamos los tipos de variables que tenemos.
Primera separación: las variables cuantitativas, que se expresan como valores numéricos:
agebmichildrencharges
Luego, las variables cualitativas, que se expresan por categorías o etiquetas:
smoker(sí / no)region(noreste, noroeste, sureste, suroeste)sex(male / female)
Distribución del costo
Por ejemplo, para entender cómo se distribuye el gasto médico, agrupamos los valores de charges en intervalos (bins) en el eje , y en el eje contamos cuántas personas caen en cada intervalo.
sns.histplot(data=insurance_data, x="charges", bins=30, kde=True)
plt.title("Distribución del costo médico")
plt.xlabel("Costo")
plt.ylabel("Frecuencia")
plt.show()
Este histograma ayuda a entender por qué la regresión lineal simple (edad contra costo) tenía tanto error. En la dispersión de edad contra costo vimos muchos puntos lejos de la recta; esas diferencias son el error .
En el histograma se ven dos picos. El eje (frecuencia) indica cuántas personas caen en cada rango de costo. Por ejemplo, la barra más alta, con unas 200 personas, está en los costos más bajos (hasta unos 3,200), y más de la mitad de las personas (712 de 1338) paga menos de 10,000. Luego la frecuencia baja y vuelve a subir, formando un segundo pico entre 30,000 y 45,000.
¿Por qué hay dos picos?
Probablemente el dataset mezcla dos poblaciones:
- Pico izquierdo: no fumadores, con costos médicos bajos.
- Pico derecho: fumadores, con costos médicos más altos.
Como solo usamos la edad, sospechamos que falta una variable importante: fumador. Un fumador joven puede tener un costo alto, y un no fumador mayor, un costo bajo. Por eso el modelo con solo la edad falla tanto.
Para mejorarlo, podríamos pasar a una regresión lineal múltiple.
Regresión lineal simple y múltiple
Hasta ahora usamos una sola variable de entrada para predecir: eso es una regresión lineal simple. Una regresión lineal múltiple es la misma idea con varias variables de entrada a la vez: cada una tiene su propia pendiente, y el promedio de es la suma de todas sus contribuciones.
La diferencia clave:
- Lineal simple:
- Lineal múltiple:
Es la misma recta de antes con otras letras, la notación estándar de estadística: cumple el papel de (el intercepto), y cada es como una propia de cada variable. Con el error, el modelo completo queda:
La variable a predecir. es la variable dependiente: en nuestro caso, el costo médico.
En nuestro caso, por ejemplo:
donde diría cuánto sube el costo por cada año de edad, y , cuánto sube por fumar. Los coeficientes se estiman igual que antes, por mínimos cuadrados, solo que ahora son varios a la vez. Con dos variables, la "recta" se convierte en un plano y, con más, en un hiperplano, pero sigue siendo una sola ecuación lineal. Por ahora esto es solo una hipótesis más; la pondremos a prueba cuando entrenemos el modelo.
Para eso, fumador se codifica como 0 o 1. Haremos lo mismo con otras variables, como sex, que es categórica (male o female) y también puede codificarse como 0 o 1.
from sklearn.preprocessing import LabelEncoder, OneHotEncoder
from sklearn.compose import ColumnTransformer

LE = LabelEncoder()
insurance_data["smoker"] = LE.fit_transform(insurance_data["smoker"])
insurance_data["sex"] = LE.fit_transform(insurance_data["sex"])

# OneHot para region
ct = ColumnTransformer(
    transformers=[("region", OneHotEncoder(drop="first"), ["region"])],
    remainder="passthrough"
)smokerysex→LabelEncoderestá bien, porque son binarias (0 / 1).region→ mejorOneHotEncoder, que convierte una variable categórica en varias columnas de 0 y 1, una por cada categoría.
| noreste | noroeste | sureste | suroeste |
|---|---|---|---|
| 1 | 0 | 0 | 0 |
| 0 | 1 | 0 | 0 |
| 0 | 0 | 1 | 0 |
| 0 | 0 | 0 | 1 |
Con drop="first" además se quita la primera columna (noreste): una fila con 0 en las otras tres ya significa noreste, así que esa columna no aportaba nada nuevo.
En cambio, con LabelEncoder quedaría:
noreste  → 0
noroeste → 1
sureste  → 2
suroeste → 3
Y eso haría que nuestro modelo de regresión pensara que suroeste vale más que sureste, o que las regiones tienen un orden.
¿Fumar pesa en el costo?
Pero antes de aplicar estos cambios, verifiquemos si nuestra hipótesis es cierta: ¿fumar tiene realmente peso en el dataset?
sns.histplot(data=insurance_data, x="charges", hue="smoker", bins=30, kde=True)En el histograma volvemos a ver los intervalos, ahora separados por grupo: casi todas las personas que no fuman (el 94 %) tienen un costo menor de 20 mil, y sus barras más altas llegan a unas 200 personas, mientras que las que sí fuman tienden a pagar seguros médicos mucho más caros.
La distribución azul (fumadores) es mucho más "plana" y está desplazada hacia la derecha, con su pico principal entre 30,000 y 40,000. Aunque hay fumadores con costos bajos, la masa de datos se concentra en rangos de costo mucho más altos que los de los no fumadores.
sns.boxplot(data=insurance_data, x="smoker", y="charges")En este diagrama de caja, la línea del medio es la mediana, la caja azul contiene el 50 % central de los datos y los bigotes muestran el rango normal.
Los fumadores presentan una caja altísima, con una mediana de unos 34,000 y un bigote que llega casi a 64,000, lo que asocia fumar a costos médicos altísimos. Por el contrario, los no fumadores tienen una caja baja, con una mediana de unos 7,000, y la mayoría gasta entre 1,000 y 22,000.
Los círculos acumulados sobre los no fumadores son valores atípicos (outliers): se apilan verticalmente porque hay bastantes personas en esa situación, 46 no fumadores con gastos por encima de los 22,000.
Entrenamiento
Antes de entrar de lleno en esto, es importante plantear otras hipótesis además de la de los fumadores, porque a partir de ellas sabremos qué tipo de regresión hacer, simple o múltiple. Con esas hipótesis podemos mejorar el modelo comparando los distintos entrenamientos.
Para saber si nuestro modelo funciona correctamente, lo medimos con el error cuadrático medio (MSE). Si fuera un algoritmo de clasificación, usaríamos la exactitud (accuracy), que mide cuántas instancias se clasificaron correctamente.
En este caso, para asegurarnos de que el modelo funciona con datos reales, usamos la técnica que vimos antes: separar los datos.
- Train: estudiar (ver y aprender).
- Test: el examen final (evaluar con datos que nunca vio).
En otras palabras, el conjunto de datos se divide en subconjuntos más pequeños de entrenamiento y de prueba (validación). Es importante que las filas que están en test no estén en train, porque test contiene los valores que queremos predecir. Si el modelo los viera, estaría haciendo trampa: no puede estudiar sabiendo las respuestas.
Primero aplicamos el ColumnTransformer que preparamos:
insurance_data = pd.DataFrame(
    ct.fit_transform(insurance_data),
    columns=ct.get_feature_names_out()
)
remainder__ es el prefijo que el ColumnTransformer les pone a las columnas que deja pasar sin transformar (remainder="passthrough"), así que ahora smoker se llama remainder__smoker y charges, remainder__charges.
Vamos a entrenar dos modelos y compararlos: primero uno simple, con una sola variable (la de nuestra hipótesis, smoker), y después uno múltiple, con todas.
Regresión lineal simple: solo smoker
Una regresión lineal simple usa una sola variable de entrada; es exactamente el del principio, donde es si la persona fuma (1) o no (0).
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error, r2_score
import numpy as np

# Una sola variable: smoker (usando el nombre corregido tras la transformación)
X_simple = insurance_data[["remainder__smoker"]]
y = insurance_data["remainder__charges"]

X_train, X_test, y_train, y_test = train_test_split(
    X_simple, y, test_size=0.2, random_state=42
)

model_simple = LinearRegression()
model_simple.fit(X_train, y_train)

y_pred = model_simple.predict(X_test)

print("Intercepto:", model_simple.intercept_)
print("Pendiente:", model_simple.coef_)
print("R²:", r2_score(y_test, y_pred))
print("RMSE:", np.sqrt(mean_squared_error(y_test, y_pred)))Intercepto: 8578.322547999996
Pendiente: [23188.68587068]
R²: 0.6602486589056528
RMSE: 7262.641718240427Leído con la recta del principio: el intercepto es lo que el modelo predice para alguien que no fuma (), y la pendiente es cuánto le suma por fumar. A un fumador () le predice .
residuos = y_test - y_pred

plt.figure(figsize=(8,6))
plt.scatter(y_pred, residuos, alpha=0.5)
plt.axhline(0, color="red", linestyle="--")
plt.xlabel("Predicciones")
plt.ylabel("Residuos (real - predicho)")
plt.title("Residuos vs. Predicciones (Simple con smoker)")
plt.show()fumano fuma
268 personas que el modelo nunca vio · R² = 0,66
Pasa el puntero por un punto para ver quién es y qué tan lejos quedó su costo real de la predicción.
Esta gráfica es perfecta para entender qué gana y qué pierde el modelo simple.
Lo que muestra. Ya no hay una nube continua, sino dos columnas verticales de puntos. La de la izquierda (unos $8,578) son los no fumadores: el modelo les predijo lo mismo a todos, sin importar su edad, su IMC o lo demás. La de la derecha (unos $31,767) son los fumadores. Cada punto dentro de una columna es una persona, y su altura es su residuo: qué tan lejos quedó su costo real del valor predicho para su grupo.
Lo que ganamos. El modelo ya distingue a fumadores de no fumadores, porque tiene la variable smoker: el error de cada grupo, en promedio, queda cerca de cero. Pero fíjate en la columna de los fumadores: sigue partida en dos. Arriba quedan los fumadores con obesidad (IMC de 30 o más), que pagan mucho más de lo predicho, y abajo los que no la tienen, que pagan mucho menos. Es la misma división que veremos en el modelo múltiple, solo que aquí cabe en una sola columna.
Lo que perdimos. Dentro de cada columna, los residuos siguen siendo enormes. En la de los fumadores hay puntos desde unos −15,000 hasta más de 30,000: hay fumadores cuyo costo real es de $20,000 y otros de $60,000, y el modelo les predice lo mismo a todos, $31,767. Esto ocurre porque el modelo ignora todo lo demás (edad, IMC, hijos, región) y solo usa smoker.
Regresión lineal múltiple: todas las variables
Ahora ponemos a prueba la hipótesis de antes: usar todas las variables a la vez, es decir, una regresión lineal múltiple como la que vimos en la sección de regresión simple y múltiple. Para eso hay que separar X e y:
- X: todas las variables de entrada (edad, sexo, IMC, hijos, fumador, regiones).
- y:
charges(lo que queremos predecir).
X = insurance_data.drop("remainder__charges", axis=1)
y = insurance_data["remainder__charges"].values
Preparamos los datos de train y test con la misma división (random_state=42), así que los dos modelos se evalúan con las mismas personas.
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
Una vez separados los datos en train y test, es momento de entrenar nuestro modelo.
from sklearn.linear_model import LinearRegression
model = LinearRegression()
model.fit(X_train, y_train)
Después de esto, falta validar y predecir. Una de las cosas más importantes del proceso es que, una vez validado el modelo, podamos usarlo para predecir con datos nuevos (no para entrenarlo de nuevo), y así analizar si funciona correctamente con datos futuros. Si no quedamos satisfechos con este entrenamiento, planteamos hipótesis nuevas y vamos comparando.
y_pred = model.predict(X_test)print("Training R2: ", model.score(X_train, y_train))
print("Testing R2: ", model.score(X_test, y_test))Training R2: 0.7417255854683333
Testing R2: 0.7835929767120722Training R² = 0.7417: con los datos de entrenamiento, el modelo explica el 74.17 % de la variabilidad del costo médico.
Testing R² = 0.7835: con los datos de prueba (que el modelo nunca vio), explica el 78.35 % de la variabilidad.
¿Qué significa esto en la práctica?
- El modelo es bueno: explica más del 74 % de los costos.
- El R² de test (0.78) es mayor que el de train (0.74).
- Eso significa que no hay overfitting. Si lo hubiera, el R² de train sería altísimo (por ejemplo, 0.95) y el de test, bajo (por ejemplo, 0.60).
- El modelo generaliza bien: funciona igual o mejor con datos que nunca vio.
Real contra predicho
Para visualizar mejor el valor de R² podemos usar una gráfica de valores reales contra valores predichos.
import matplotlib.pyplot as plt

plt.figure(figsize=(8,6))
plt.scatter(y_test, y_pred, alpha=0.5)
plt.plot([y_test.min(), y_test.max()],
         [y_test.min(), y_test.max()],
         color="red", linestyle="--")
plt.xlabel("Valores reales")
plt.ylabel("Valores predichos")
plt.title("Real vs. Predicho (R² = 0.78)")
plt.show()fumano fuma
268 personas que el modelo nunca vio · R² = 0,78
Pasa el puntero por un punto para ver quién es y qué tan lejos quedó su costo real de la predicción.
Para entenderla, imagina que cada punto es una persona: el eje X es su costo real y el eje Y, el costo que predijo el modelo.
La línea punteada es la predicción perfecta (). Si todos los puntos cayeran sobre ella, tendríamos R² = 1; cuanto más se dispersan alrededor de la línea, menor es el R².
¿Realmente nuestro modelo es bueno?
Ahora podemos hacer una gráfica de los residuos, es decir, del costo real menos el costo que predijo el modelo:
residuos = y_test - y_pred

plt.figure(figsize=(8,6))
plt.scatter(y_pred, residuos, alpha=0.5)
plt.axhline(0, color="red", linestyle="--")
plt.xlabel("Predicciones")
plt.ylabel("Residuos (real - predicho)")
plt.title("Residuos vs. Predicciones")
plt.show()fumano fuma
268 personas que el modelo nunca vio · R² = 0,78
Pasa el puntero por un punto para ver quién es y qué tan lejos quedó su costo real de la predicción.
¿Qué nos dice la gráfica de residuos?
Esta gráfica nos ayuda a ver si el modelo falla de forma aleatoria o si tiene un problema de fondo. Para leerla hay que fijarse en la distancia entre cada punto y la línea del cero, sin importar si el punto está arriba o abajo: esa distancia es el tamaño del error, y a mayor distancia, menos acertó el modelo.
Si el punto está arriba de la línea, el residuo es positivo y el modelo subestimó: predijo un costo menor al real. Por ejemplo, si predijo $10,000 y el costo real fue $20,000, el error fue de $10,000. Si el punto está abajo, el residuo es negativo y el modelo sobreestimó: predijo un costo mayor al real. Por ejemplo, si predijo $20,000 y el costo real fue $10,000, el error fue de menos $10,000. En ambos casos el error es de $10,000; solo cambia la dirección.
Ahora bien, cuando los residuos forman un patrón claro, como una "U" o dos bandas separadas, estamos ante un error sistemático y no aleatorio. La regresión lineal supone que los errores son ruido blanco: puntos dispersos, sin forma, alrededor de la línea del cero. Si aparece un patrón, significa que la relación entre las variables y el costo no es puramente lineal, o que falta algo importante, como una interacción entre el IMC y el hecho de fumar. En resumen, la gráfica de residuos no solo muestra cuánto se equivoca el modelo, sino cómo se equivoca, y en nuestro caso revela que una sola ecuación lineal no basta para capturar la complejidad de los datos.
Verificando si es un modelo confiable
from sklearn.metrics import mean_squared_error, r2_score
import numpy as np

y_train_pred = model.predict(X_train)
y_test_pred = model.predict(X_test)

# MSE
mse_train = mean_squared_error(y_train, y_train_pred)
mse_test = mean_squared_error(y_test, y_test_pred)

# RMSE
rmse_train = np.sqrt(mse_train)
rmse_test = np.sqrt(mse_test)

# R²
r2 = r2_score(y_test, y_test_pred)

print("MSE Train: ", mse_train)
print("MSE Test:  ", mse_test)
print("RMSE Train:", rmse_train)
print("RMSE Test: ", rmse_test)
print("R2: ", r2)MSE Train: 37277681.70201866
MSE Test: 33596915.85136149
RMSE Train: 6105.545160099847
RMSE Test: 5796.284659276275
R2: 0.7835929767120722El RMSE (error promedio en dólares)
RMSE Train: 6105.54
RMSE Test:  5796.28
En promedio, nuestro modelo se equivoca por unos $5,796 cuando predice el costo médico de personas que nunca vio (test). El RMSE no es un promedio simple de los errores: al elevarlos al cuadrado antes de promediar, pesa más los errores grandes, así que es una medida algo exigente del error típico.
El R²
R2: 0.7835El modelo explica el 78.35 % de la variabilidad de los costos médicos.
La relación entre train y test
Lo normal sería que el modelo funcionara mejor en train que en test. Aquí es al revés, pero la diferencia es pequeña. Algo importante que vale la pena destacar de nuevo es que no hay overfitting: el modelo no se aprendió los datos de memoria, sino la relación general, y la aplica bien a datos nuevos. El error en train y en test es casi el mismo, lo que indica que generaliza correctamente.
Por lo tanto, podemos decir que el modelo explica el 78 % de los costos, se equivoca en promedio por $5,796 y no muestra señales de overfitting. Es un modelo confiable.
¿Por qué quedan las bandas?
Ojo con una confusión fácil: cuando decimos "una sola recta" nos referimos a una sola ecuación lineal, no a una sola variable. Nuestro modelo múltiple tiene 8 coeficientes, uno por cada variable de entrada (edad, sexo, IMC, hijos, fumador y las tres regiones codificadas). Con tantas variables, esa "recta" ya no es una línea en 2D sino un plano o, en más dimensiones, un hiperplano; pero sigue siendo una única ecuación lineal.
Nuestro modelo falla de forma sistemática porque intenta ajustar una sola ecuación lineal a poblaciones distintas. Por un lado, sobreestima a la mayoría de los no fumadores (residuo negativo en 7 de cada 10): la recta se desplaza hacia arriba para intentar alcanzar los costos elevados de los fumadores, y les asigna predicciones más altas que sus costos reales. Por otro lado, a los fumadores los parte en dos: subestima a los fumadores con obesidad, es decir, con un IMC de 30 o más (residuo positivo en 29 de 30), y sobreestima a los fumadores sin obesidad (residuo negativo en 22 de 24). El modelo le suma a cada fumador el mismo extra por fumar, pero en los datos ese extra es mucho mayor cuando además hay obesidad. Este error no es aleatorio: es el que genera las bandas visibles en la gráfica de residuos.
El problema de fondo no es que falten variables: ya usamos varias (edad, IMC, hijos, sexo, región y fumador). El problema es que una sola ecuación no puede separar a fumadores de no fumadores, porque el efecto de algunas variables cambia según el grupo. Por ejemplo, en los fumadores cada punto de IMC sube el costo en unos $1,473, mientras que en los no fumadores apenas lo sube en $83. Para resolverlo, no basta con agregar más variables: hay que agregar interacciones (como imc * fumador) o separar los grupos y entrenar un modelo para cada uno.
Simple contra múltiple
| Métrica | Simple con smoker | Múltiple |
|---|---|---|
| R² | 0.66 | 0.78 |
| RMSE | $7,262 | $5,796 |
| Residuos | dos columnas | dos bandas |
El modelo simple explica menos (66 % contra 78 %) y se equivoca más ($7,262 contra $5,796), pero sus errores ya no mezclan a fumadores con no fumadores.
- Simple con
smoker: elimina el error entre fumadores y no fumadores, pero deja mucho error dentro de cada grupo. - Múltiple sin interacciones: mejor R², pero con error sistemático, porque una sola ecuación trata igual a los dos grupos.
- Múltiple con interacciones: debería combinar lo mejor de ambos, prediciendo bien y respetando las diferencias entre grupos.
Ese es el siguiente paso natural: agregar interacciones al modelo múltiple.
Los coeficientes de nuestro modelo
Nuestro modelo múltiple tiene 8 variables (edad, sexo, IMC, hijos, fumador y 3 de región), así que estima un para cada una, más el intercepto . Podemos ver los valores que aprendió nuestro modelo múltiple:
print("Intercepto:", model.intercept_)
print(pd.Series(model.coef_, index=X.columns))Intercepto: -11931.219050326616
region__region_northwest -370.677326
region__region_southeast -657.864297
region__region_southwest -809.799354
remainder__age 256.975706
remainder__sex -18.591692
remainder__bmi 337.092552
remainder__children 425.278784
remainder__smoker 23651.128856
dtype: float64Con ellos, la ecuación que aprendió nuestro modelo queda así:
Cada coeficiente es la pendiente de su variable: cada año de edad suma unos $257, cada punto de IMC unos $337, cada hijo unos $425, y fumar suma $23,651 de golpe. El sexo apenas pesa ($19), y las regiones restan un poco respecto al noreste, que es la región que quitamos con drop="first". El intercepto negativo no significa nada por sí solo: sería el costo de alguien con 0 años y un IMC de 0, que no existe; solo sirve para que la ecuación cuadre con los datos reales.
Y aquí se ve el problema de las bandas: fumar suma los mismos $23,651 a todos los fumadores, tengan o no obesidad. Una interacción como imc * fumador le daría al modelo un coeficiente extra para cobrarle más a quien fuma y además tiene un IMC alto.
Regresión múltiple con interacciones
Una interacción es una variable nueva que se arma multiplicando dos que ya teníamos. Como smoker vale 0 o 1, multiplicar por ella funciona como un interruptor:
bmi_smoker = IMC × fumadorvale 0 para quien no fuma y su IMC para quien fuma.age_smoker = edad × fumadorhace lo mismo con la edad.
Así el modelo sigue siendo una sola ecuación lineal, pero ahora tiene un coeficiente que solo se activa en los fumadores. Ese coeficiente es justo lo que le faltaba: un precio por punto de IMC distinto para quien fuma.
Crear las interacciones
Partimos de los mismos datos codificados de antes y les agregamos las dos columnas nuevas. Cada una multiplica una variable por smoker, así que en los no fumadores vale 0.
insurance_data["age_smoker"] = (
    insurance_data["remainder__age"] * insurance_data["remainder__smoker"]
)
insurance_data["bmi_smoker"] = (
    insurance_data["remainder__bmi"] * insurance_data["remainder__smoker"]
)
Entrenar el modelo
Separamos X e y igual que antes. Ahora X lleva 10 columnas: las 8 de siempre más las dos interacciones.
X = insurance_data.drop("remainder__charges", axis=1)
y = insurance_data["remainder__charges"].values
Usamos la misma división en train y test (random_state=42), así que este modelo se evalúa con las mismas personas que los anteriores.
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)
Entrenamos con el mismo LinearRegression: el método no cambia, solo las columnas que le damos.
from sklearn.linear_model import LinearRegression
model = LinearRegression()
model.fit(X_train, y_train)
Y predecimos tanto en train como en test, para poder comparar los dos.
y_train_pred = model.predict(X_train)
y_test_pred = model.predict(X_test)
Métricas
Calculamos las mismas métricas que con el modelo múltiple. Primero el MSE, el promedio de los errores al cuadrado:
from sklearn.metrics import mean_squared_error
mse_train = mean_squared_error(y_train, y_train_pred)
mse_test = mean_squared_error(y_test, y_test_pred)
print("MSE Train:", mse_train)
print("MSE Test:", mse_test)MSE Train: 23949079.98837909
MSE Test: 20922607.93807086Luego el RMSE, la raíz del MSE, que vuelve a dólares:
import numpy as np
rmse_train = np.sqrt(mse_train)
rmse_test = np.sqrt(mse_test)
print("RMSE Train:", rmse_train)
print("RMSE Test:", rmse_test)RMSE Train: 4893.779724137478
RMSE Test: 4574.1237344513165Y el R², cuánto de la variación de los costos explica el modelo:
from sklearn.metrics import r2_score
r2_train = r2_score(y_train, y_train_pred)
r2_test = r2_score(y_test, y_test_pred)
print("R2 Train:", r2_train)
print("R2 Test:", r2_test)R2 Train: 0.8340713711218875
R2 Test: 0.8652316979531679Con solo dos columnas más, el R² en test sube de 0.78 a 0.87 y el error típico (RMSE) baja de $5,796 a $4,574. Train y test siguen muy cerca (0.83 y 0.87), así que tampoco aquí hay overfitting.
Validación cruzada
Para comprobar que no fue suerte de la división, usamos validación cruzada. cross_val_score parte los datos en 5 bloques, entrena 5 veces dejando fuera un bloque distinto cada vez y mide el R² en el bloque que dejó fuera.
from sklearn.model_selection import cross_val_score
scores = cross_val_score(model, X, y, cv=5, scoring="r2")
print("R² en cada fold:", scores)
print("R² promedio:", scores.mean())R² en cada fold: [0.86202567 0.79183869 0.88062149 0.81807634 0.83220921]
R² promedio: 0.8369542785773885Los cinco resultados van de 0.79 a 0.88, con un promedio de 0.84: el modelo se comporta parecido con cualquier grupo de personas que le toque.
Real contra predicho
plt.figure(figsize=(8, 6))
plt.scatter(y_test, y_test_pred, alpha=0.5)
plt.plot(
    [y_test.min(), y_test.max()],
    [y_test.min(), y_test.max()],
    color="red", linestyle="--"
)
plt.xlabel("Valores reales")
plt.ylabel("Valores predichos")
plt.title("Real vs. Predicho (con interacciones)")
plt.show()fumano fuma
268 personas que el modelo nunca vio · R² = 0,87
Pasa el puntero por un punto para ver quién es y qué tan lejos quedó su costo real de la predicción.
Los puntos se pegan mucho más a la diagonal que con el modelo anterior, sobre todo arriba a la derecha. Las 33 personas del test con costos de más de $30,000 quedaban todas por debajo de la diagonal, con el modelo quedándose corto por unos $7,057 en la mediana; ahora 8 de ellas ya la cruzan y la mediana del error baja a $2,353.
Residuos
residuos = y_test - y_test_pred

plt.figure(figsize=(8, 6))
plt.scatter(y_test_pred, residuos, alpha=0.5)
plt.axhline(0, color="red", linestyle="--")
plt.xlabel("Predicciones")
plt.ylabel("Residuos (real - predicho)")
plt.title("Residuos vs. Predicciones (con interacciones)")
plt.show()fumano fuma
268 personas que el modelo nunca vio · R² = 0,87
Pasa el puntero por un punto para ver quién es y qué tan lejos quedó su costo real de la predicción.
Las bandas casi desaparecen. Comparado con el modelo múltiple sin interacciones:
| Grupo | Sin interacciones | Con interacciones |
|---|---|---|
| Fumadores con obesidad (IMC ≥ 30) | mediana +$6,922 | mediana +$797 |
| Fumadores sin obesidad (IMC < 30) | mediana −$9,532 | mediana −$3,902 |
| No fumadores | mediana −$1,286 | mediana −$1,443 |
Los fumadores con obesidad, que antes se quedaban cortos casi siempre, ahora quedan prácticamente centrados en cero. A los no fumadores el modelo los sigue sobreestimando un poco, pero de forma muy pareja: 9 de cada 10 tienen un residuo entre −$4,000 y 0, que es la franja apretada bajo la línea. Lo que queda por encima son 16 de 214 no fumadores (7 %) con costos más de $5,000 por arriba de lo predicho: gastos que ninguna de nuestras variables explica, como una hospitalización o una enfermedad que el dataset no registra.
Los coeficientes con interacciones
print("Intercepto:", model.intercept_)
print("Coeficientes:")
for nombre, coef in zip(X.columns, model.coef_):
print(f" {nombre}: {coef:.2f}")Intercepto: -2029.1018068883895
Coeficientes:
region__region_northwest: -631.42
region__region_southeast: -968.58
region__region_southwest: -1232.54
remainder__age: 262.98
remainder__sex: -525.60
remainder__bmi: 20.40
remainder__children: 463.19
remainder__smoker: -21271.21
age_smoker: 1.99
bmi_smoker: 1470.48El cambio más llamativo está en el IMC. Antes cada punto valía $337 para todos; ahora vale $20 para quien no fuma y $20 + $1,470 = $1,491 para quien fuma. Es casi lo mismo que habíamos medido directamente en los datos ($1,473 por punto en los fumadores): el modelo encontró por su cuenta la relación que antes no podía expresar.
age_smoker, en cambio, vale apenas $2 por año: la edad encarece igual a fumadores y no fumadores (unos $263 por año), así que esa interacción no aporta.
El coeficiente de smoker es ahora negativo (−$21,271), y eso no significa que fumar abarate. Ya no se lee solo: el extra por fumar es ahora , que depende del IMC de cada persona:
| IMC | Extra por fumar |
|---|---|
| 25 | ≈ $15,500 |
| 30 | ≈ $22,800 |
| 35 | ≈ $30,200 |
Eso es justo lo que las bandas pedían: el modelo anterior le cobraba los mismos $23,651 a todo fumador; este le cobra menos a quien fuma con un IMC normal y bastante más a quien además tiene obesidad.
Las tres versiones
| Métrica | Simple con smoker | Múltiple | Múltiple con interacciones |
|---|---|---|---|
| R² (test) | 0.66 | 0.78 | 0.87 |
| RMSE (test) | $7,262 | $5,796 | $4,574 |
| Residuos | dos columnas | dos bandas | una franja y pocos casos altos |
El modelo sigue siendo una regresión lineal: una suma de variables por coeficientes. Lo que cambió no fue el método, sino qué variables le dimos. Al construir bmi_smoker, le dejamos expresar que el IMC pesa distinto según si la persona fuma, y con eso explica el 87 % de la variación de los costos.