本文へスキップ
!
ホーム
ブログ
ギャラリー
sonido
技術ノート
Project Planning:ウィンドウ関数と CTE
最新:
Project Planning:ウィンドウ関数と CTE
データ収集
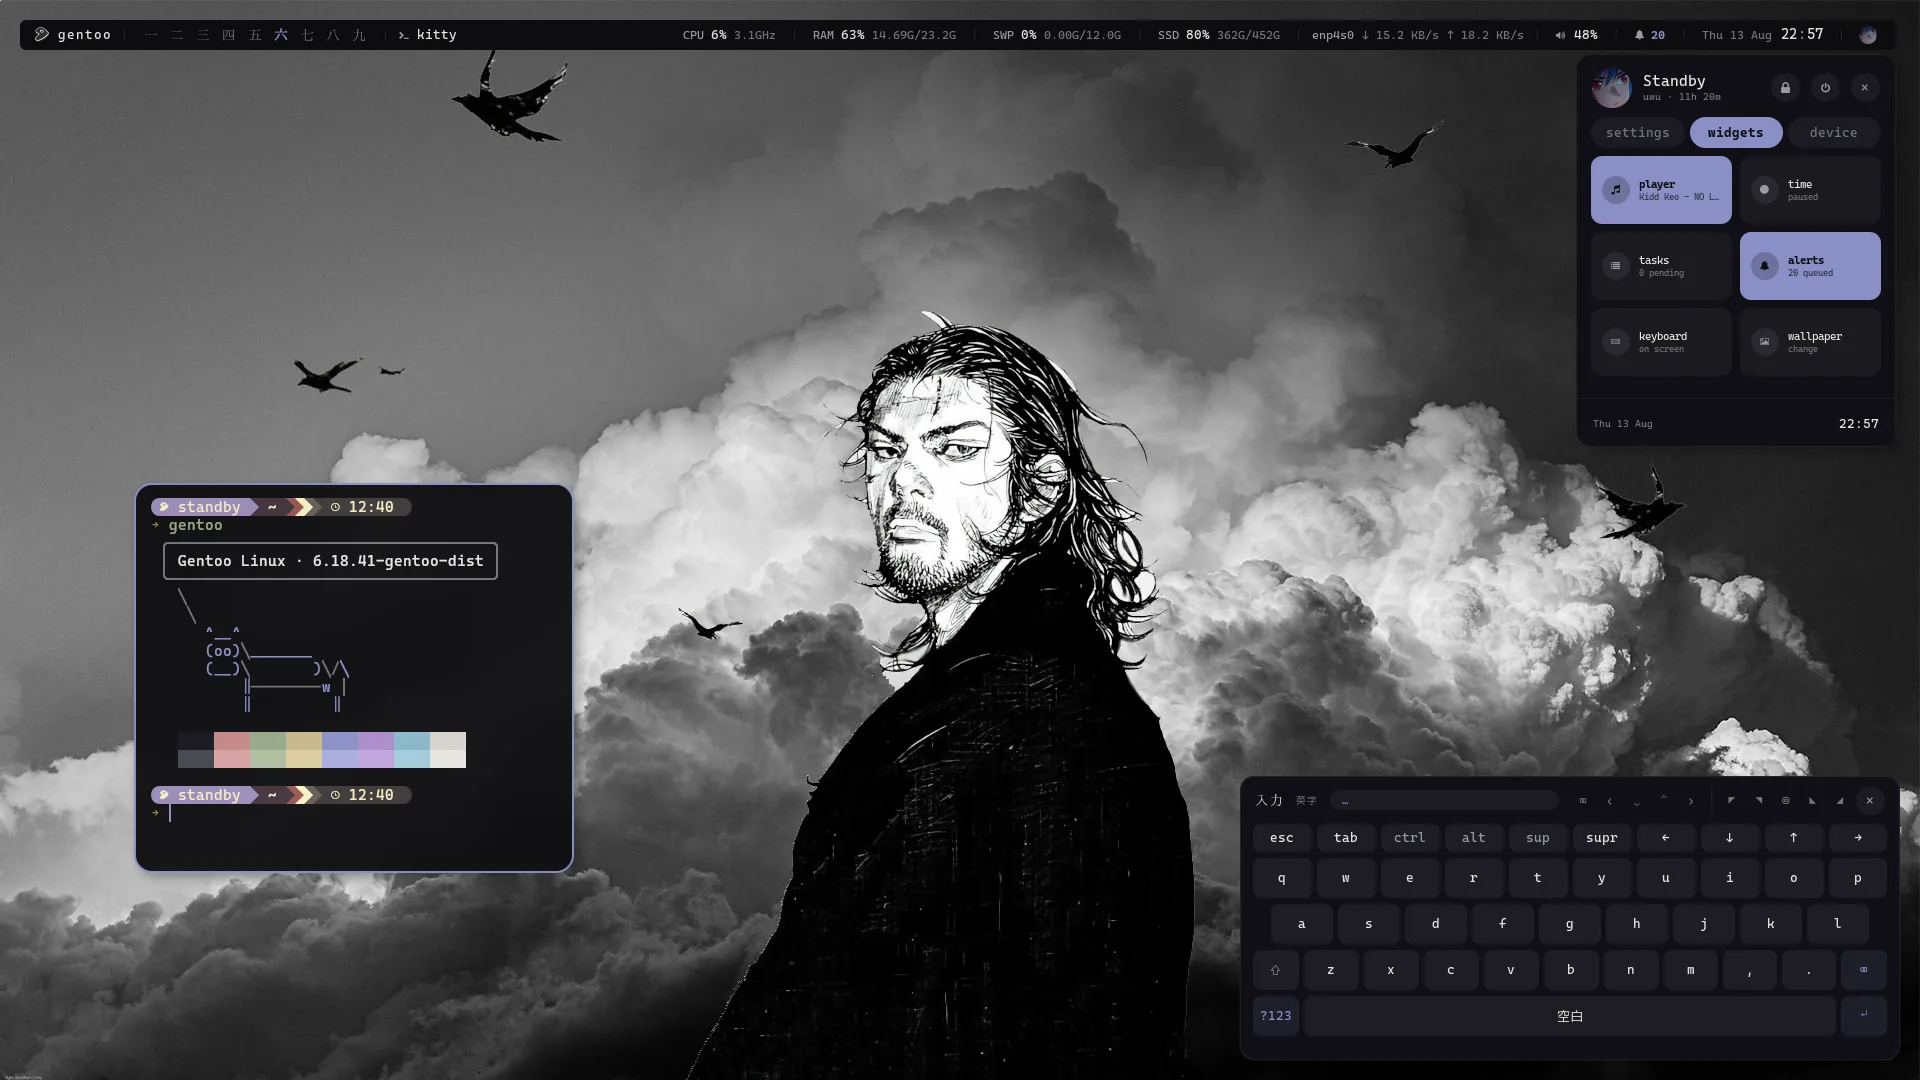
墨絵 sumi-e:私の Gentoo デスクトップ
OCCUPATIONS:整形とピボット
ノートの最新記事
検索
データサイエンス
Writeups
SQL
Linux
線形回帰
機械学習
Python
Kaggle
HackTheBox
MySQL
SQL Server
HackerRank
メモ
一次関数
直線の規則:m は傾きで、x が 1 増えるごとに y がどれだけ増えるか。b は切片で、x が 0 のときの y の値。
データ収集 より
線形回帰
ある変数の平均が別の変数に対して直線的に変わると仮定して予測すること、E(y | x) = b + mx。実際の各データは誤差 ε の分だけ直線から離れる。
データ収集 より
最小二乗法
m と b の推定方法:縦方向の誤差の二乗和を最小にする直線。閉じた式があり、それが LinearRegression の計算している内容。
データ収集 より
単回帰と重回帰
単回帰は入力変数をひとつ使う、y = β0 + β1x。重回帰は複数を同時に使い、それぞれに傾きがあるが、それでもひとつの線形方程式。
データ収集 より
交互作用
既存の 2 つの変数を掛け合わせた新しい変数(BMI × 喫煙者など)。線形方程式のまま、一方の効果がもう一方に依存するようにする。
データ収集 より
入力データとラベル
学習の前に各列を分ける:入力は x、モデルが学ぶためのもの。ラベルは y、予測したいもの。
データ収集 より
重回帰分析
同じ直線を多くの x で:変数を正規化し、学習し、検証し、残差と各変数の重要度を読む。
重回帰分析 より
INNER JOIN
共通の列で 2 つのテーブルを結合する:キーが両側に現れる行だけが残る。
CITY と COUNTRY の JOIN より
自己結合
ある行が同じテーブルの別の行を指すとき:テーブルを自分自身と結合して、誰が誰の親かを知り、各ノードを分類する。
階層:二分木と組織図 より
HAVING
グループに対する WHERE:まず GROUP BY で数え、その件数で絞り込む。ここでは別のクエリが計算した最大値と比べる。
サブクエリと HAVING より
サブクエリ
クエリの中のクエリ:ハッカーごとにまとめて数えるクエリを、もうひとつのテーブルのように外側のテーブルと結合する。
サブクエリと HAVING より
相関サブクエリ
外側の行を読むサブクエリ。そのため 1 行ごとに評価され、各行を自分のグループと比べる。
サブクエリと HAVING より
ウィンドウ関数
行をまとめずに隣の行を使って計算する:LAG は前の日付を取り出し、SUM OVER は各プロジェクトに番号を振るカウンターを累積する。
Project Planning:ウィンドウ関数と CTE より
PIVOT を使わないピボット
MySQL には PIVOT がないので、ROW_NUMBER で各グループに番号を振り、CASE WHEN で列に振り分けて行を列に変える。
OCCUPATIONS:整形とピボット より
マンハッタン距離
2 点の座標の差の絶対値の和:|a − c| + |b − d|。
STATION:幾何と中央値 より
ユークリッド距離
2 点を結ぶ直線:差の二乗和の平方根。
STATION:幾何と中央値 より
中央値
すべてを並べたときに真ん中に来る値:SQL では、並べ替えて半分の行を飛ばす。
STATION:幾何と中央値 より
テーマで記事を絞り込む
すべて
データサイエンス
Writeups
SQL
Linux
Medical Cost · データ収集
データサイエンス ·
2026/10/06
墨絵 sumi-e:私の Gentoo デスクトップ
Linux ·
2026/10/01
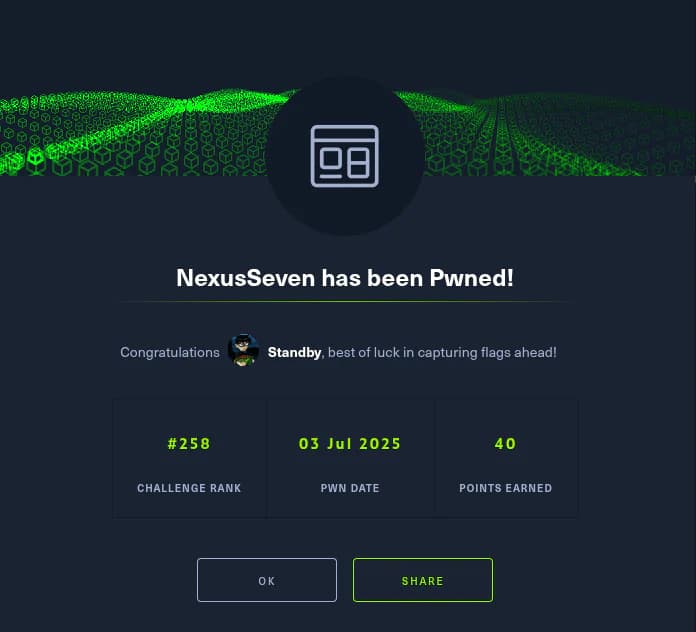
NexusSeven
Writeups ·
2025/07/04
COVID-19 が教育に与えた影響
シリーズ · 5 本の記事 ·
2024/06/27
新着
HackerRank の SQL
シリーズ · 11 本の記事 ·
2026/10/06
メモ。
記事の中で説明している考え方です。それぞれ該当する節へ移動します。
線形回帰
ある変数の平均が別の変数に対して直線的に変わると仮定して予測すること、E(y | x) = b + mx。実際の各データは誤差 ε の分だけ直線から離れる。
最小二乗法
m と b の推定方法:縦方向の誤差の二乗和を最小にする直線。閉じた式があり、それが LinearRegression の計算している内容。
INNER JOIN
共通の列で 2 つのテーブルを結合する:キーが両側に現れる行だけが残る。
ウィンドウ関数
行をまとめずに隣の行を使って計算する:LAG は前の日付を取り出し、SUM OVER は各プロジェクトに番号を振るカウンターを累積する。
01
Project Planning:ウィンドウ関数と CTE
02
データ収集
03
墨絵 sumi-e:私の Gentoo デスクトップ
ノートをフォロー
新しい記事は RSS で届きます。このリンクをリーダーに貼り付けてください。
RSS フィードのリンク
リンクをコピー
コピーしました
フィードを開く
 Medical Cost · データ収集